ブログ › IT
Googleにインデックスされない原因、正体はhreflangのスラッシュ二重だった
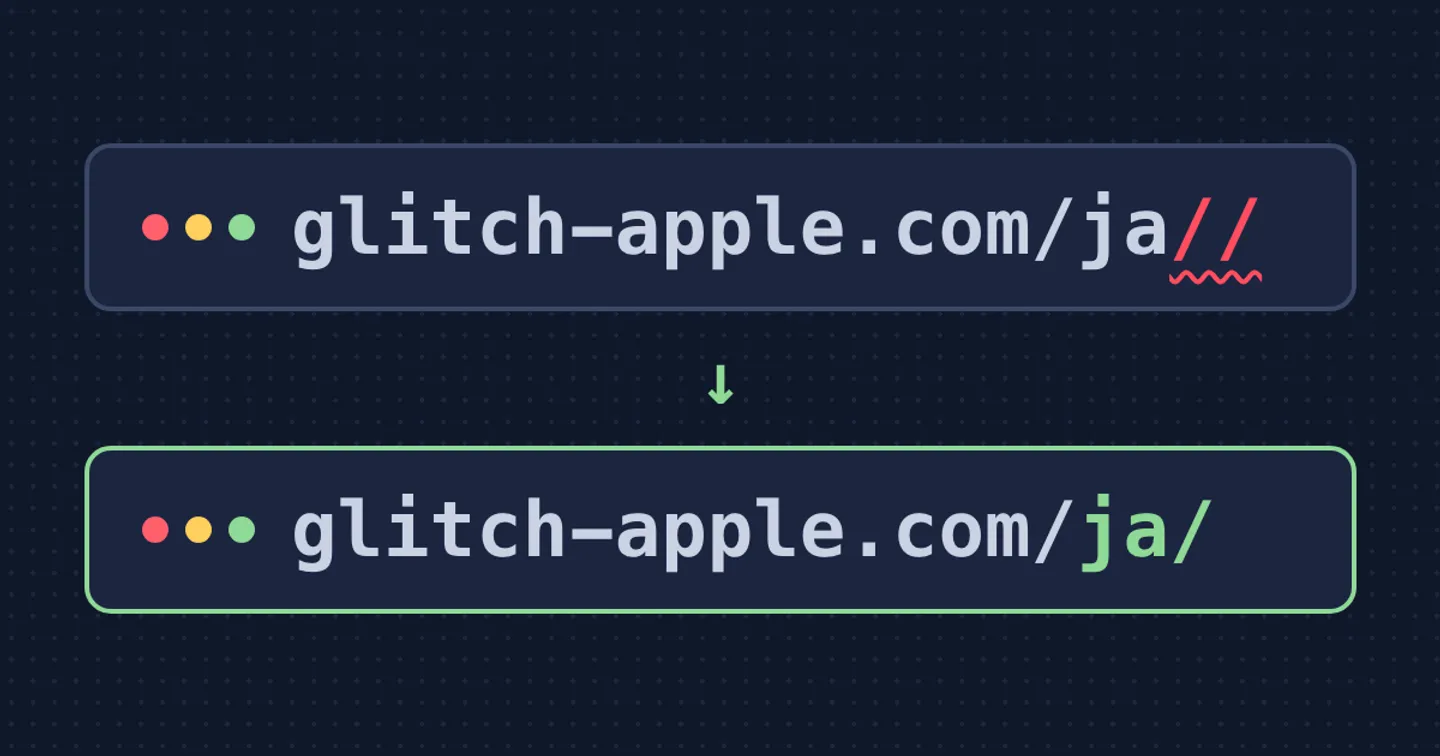
このブログは韓国語・日本語・英語の3言語で運営している。だから記事を1本公開すると3つのURLができる(例:/ko/記事名/、/ja/記事名/、/en/記事名/)。この3つが「同じ記事の別言語版だ」とGoogleに伝えるタグが別にあって、これをhreflangと呼ぶ。
Googleは自分のサイトを「検索結果に出してよいページ」と判断すると、インデックス(index)に入れる。インデックスに入らなければ、どれだけ記事を書いても検索からは絶対に入ってこない。だからSearch Console(Googleが自分のサイトをどう見ているか確認するツール)をたまに開くのだが、数日前に開いたら「失敗」ラベルが付いた項目が44件も出ていた。
カテゴリが5つに分かれていたが、名前だけ見てもどれが本当の問題なのか全く見当がつかなかった。
- 代替ページ(適切な canonical タグあり) — 20件
- ページにリダイレクトがあります — 13件
- 重複しています。ユーザーにより、正規ページとして選択されていません — 5件
- クロール済み - インデックス未登録 — 4件
- 重複しています。Google により、ユーザーがマークしたページとは異なるページが正規ページとして選択されました — 2件
44件。最初はサイト全体に問題があるのかと思った。
でも一つずつURLを開いてみると話が違った。「代替ページ(適切な canonical タグあり)」と「ページにリダイレクトがあります」は、ほとんどがwww.が付いていたりhttp://で始まるアドレスだった。こういうものは元々本物のアドレス(https://glitch-apple.com/...)へ自動で転送(リダイレクト)するようにしてあって、その本物のアドレスさえインデックスされていればそれで正常。Googleが「失敗」と書くから驚いただけで、33件(20+13)はそもそも正常な動作だった。
本当の問題は残りの中に紛れていた。「重複しています。ユーザーにより、正規ページとして選択されていません」のリストに、こんなアドレスがあった。
https://glitch-apple.com/ko//
https://glitch-apple.com/ja//
スラッシュが2つある。こんなアドレスを作った覚えはないのに、Googleは一体どこで見つけてきたのかしばらく考えた。
答えはサイト自体の<head>の中にあった。ホーム画面のソースを開いてみると:
<link rel="alternate" hreflang="ja" href="https://glitch-apple.com/ja//">
<link rel="alternate" hreflang="en" href="https://glitch-apple.com/en//">
自分で「日本語版はここにある」と伝えているタグの中に、スラッシュが2つ入っていた。Googleはこのタグをそのまま信じてたどり着き、存在しない二重スラッシュのアドレスを「発見」して、どこにリダイレクトされるかも確認し、結局「正規URLが不明な重複ページ」に分類してしまったわけだ。自分が作ったタグがGoogleを変なところへ連れて行った格好になる。
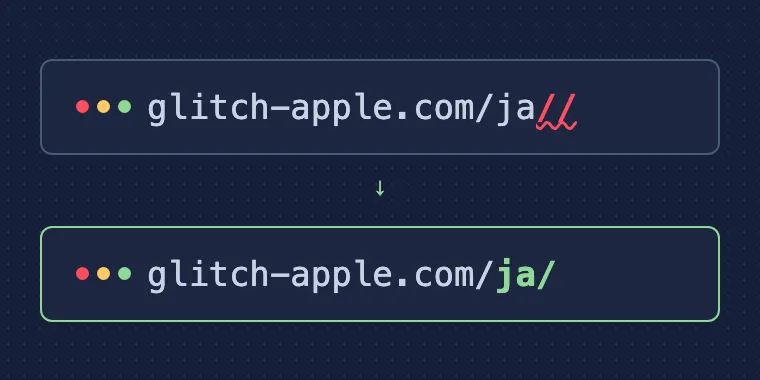
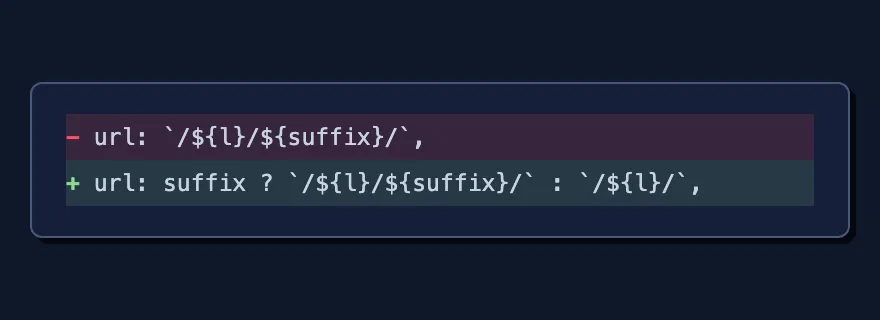
原因はコード1行だった。
url: `/${l}/${suffix}/`,パスの後に何かが付くページ(/ja/blog/のような)は問題ないが、ホーム画面のように後ろに何も付かないページは、このsuffixの部分が空文字列になり、/ja/ + “ + /がつながって/ja//になってしまう。ちょうど韓国語・日本語・英語のホーム画面3つだけがこれに引っかかっていた。
url: suffix ? `/${l}/${suffix}/` : `/${l}/`,空文字列のときはスラッシュを1つだけ付けるように変えた。それだけだった。
デプロイしてもう一度ソースを開くと、hreflangの値が全部正常になっていた。あとはGoogleが再クロールすれば、あの二重スラッシュのアドレスも自然に整理されるはずだ。
今回感じたのは、「失敗」という言葉をそのまま信じてはいけないということだった。44件のうち、本当に自分が直すべきだったのは2、3件だけで、残りは元々正常か、コードとは関係ない問題(新しく買ったドメインだからGoogleの信頼がまだ十分に積み上がっていないこと)だった。全部同じ「失敗」ラベルが付いているから、一つずつ開いてみるまでは何が本物か見分ける方法がなかった。
コメント